 ×
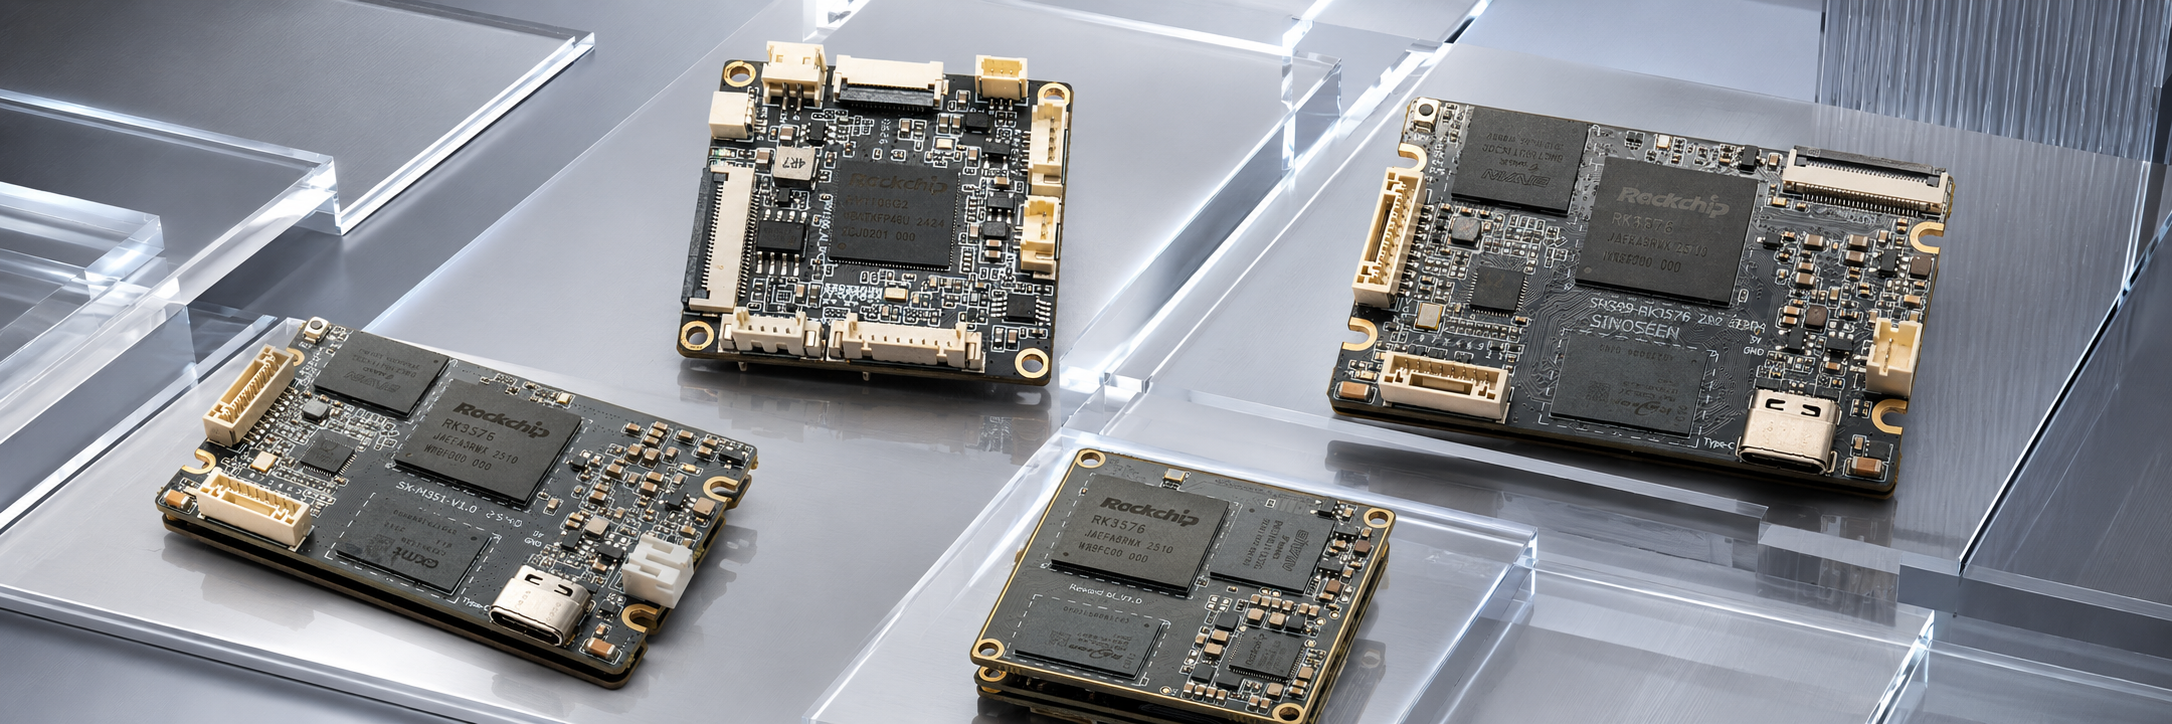
Sélectionner le bon calcul en Bord une architecture pour sites distribués exige un alignement rigoureux entre les capacités techniques, les objectifs métiers et les contraintes d’infrastructure. À mesure que les organisations étendent leurs activités sur plusieurs lieux, la demande de traitement en temps réel, de réduction de la latence et d’intelligence localisée n’a jamais été aussi forte. Le choix de votre architecture influencera directement l’efficacité opérationnelle, la sécurité des données et la capacité à réagir aux événements IoT avec un délai minimal.
La décision fondamentale liée au déploiement de solutions de calcul en périphérie repose sur la compréhension de l’endroit où le traitement doit avoir lieu : sur des sites distants, dans des centres régionaux ou selon un modèle hybride. Ce guide vous accompagne à travers les facteurs critiques de sélection, allant des exigences de latence et de la densité des capteurs IoT à la fiabilité du réseau et à la puissance de calcul requise sur chaque site distribué. D’ici 2026, les modèles de déploiement du calcul en périphérie évolueront probablement vers des architectures plus sophistiquées, pilotées par l’IA, ce qui rend indispensable la construction de cadres suffisamment souples pour évoluer.
La latence est le principal facteur déterminant les décisions en faveur de l’informatique en périphérie pour les sites distribués. Lorsque des capteurs IoT génèrent des données critiques en temps réel — par exemple, la surveillance de l’état des machines, l’analyse vidéo ou les signaux de commande autonome — même un délai de quelques millisecondes peut compromettre la sécurité, la qualité ou l’expérience utilisateur. Évaluez la tolérance à la latence de chaque charge de travail applicative : les processus critiques peuvent exiger des temps de réponse inférieurs à 100 millisecondes, tandis que les analyses et les rapports peuvent supporter des retards de plusieurs secondes.
Votre architecture de calcul en périphérie doit traiter les données là où elles sont générées, plutôt que d’acheminer des flux bruts vers un centre de cloud central. Cela réduit la bande passante nécessaire pour le transfert des données vers le centre, évite la congestion du réseau et garantit des performances stables, même lorsque la connectivité Internet devient instable. Documentez la latence maximale acceptable pour les cas d’utilisation principaux de chaque site distribué, puis concevez l’emplacement des ressources de calcul et le flux de données en conséquence. Les applications impliquant l’automatisation IoT en temps réel, la maintenance prédictive ou des décisions critiques pour la sécurité tirent généralement le plus grand avantage d’un traitement local en périphérie.
L’ampleur et le type des dispositifs IoT présents sur chaque site distribué déterminent la capacité de calcul et de stockage que votre solution de calcul en périphérie doit offrir. Les environnements IoT à forte densité — tels que les lignes de production équipées de centaines de capteurs, les systèmes de bâtiments intelligents ou les réseaux de surveillance à distance — génèrent des flux continus qui submergent le traitement centralisé dans le cloud et consomment une bande passante prohibitivement élevée. Recensez le nombre de capteurs IoT, la fréquence d’acquisition des données et la taille de la charge utile par site afin d’établir la demande de traitement de base.
Prenez en compte non seulement la charge actuelle des capteurs, mais aussi la croissance prévue d’ici 2026. Les organisations qui intègrent de nouvelles fonctionnalités IoT ou étendent l’automatisation à l’ensemble de leurs installations ont besoin d’architectures capables de s’adapter progressivement. La réservation anticipée de capacités de calcul en périphérie pour répondre à la croissance future des dispositifs IoT permet d’éviter des refontes coûteuses et des perturbations liées aux migrations. Les architectures de sites distribués doivent modulariser les ressources de calcul afin que des unités de traitement supplémentaires puissent s’intégrer sans heurt à mesure que la densité des dispositifs IoT augmente.
Trois modèles d’architecture principaux pour le calcul en périphérie desservent les sites distribués, chacun comportant des compromis spécifiques. Un modèle périphérique centralisé concentre les ressources de calcul sur un petit nombre de nœuds régionaux, réduisant ainsi la complexité opérationnelle et l’investissement matériel, mais introduisant une latence de retour (backhaul) et des risques de défaillance ponctuelle. Cette approche convient aux organisations dont les schémas de trafic sont prévisibles et dont les charges de travail ne sont que faiblement sensibles au temps. À l’inverse, le calcul en périphérie entièrement distribué place des ressources de calcul à chaque site distant, garantissant une latence minimale et une résilience maximale, mais multipliant la complexité de gestion, de maintenance et de licences sur des dizaines, voire des centaines, d’emplacements.
Les déploiements les plus matures adoptent un modèle hybride de calcul en périphérie qui hiérarchise le traitement : les tâches critiques en termes de latence s’exécutent sur site à l’aide de ressources informatiques légères, tandis que les analyses gourmandes en ressources et le stockage à long terme exploitent des installations régionales ou dans le nuage. Cette approche équilibrée tire parti des avantages du calcul en périphérie là où la latence est primordiale, tout en maîtrisant les coûts opérationnels. Les conceptions hybrides s’intègrent bien aux charges de travail IoT qui combinent fusion de capteurs en temps réel et analyse par lots. Évaluez votre mélange de charges de travail, les contraintes liées à vos effectifs informatiques et votre budget afin de déterminer l’emplacement optimal pour vos sites distribués.
La topologie du réseau influence les performances et la résilience du calcul en périphérie dans les environnements distribués. Si tous les nœuds de calcul en périphérie situés sur des sites distants doivent communiquer via une seule liaison montante vers un centre de gestion central, vous courez le risque de goulots d’étranglement et de pannes en cascade. Mettez en œuvre un regroupement en réseau local, où les nœuds de calcul en périphérie peuvent collaborer avec leurs voisins avant d’envoyer des informations agrégées vers l’amont. Cette conception réduit la bande passante du réseau principal, améliore l’isolement des pannes et renforce la résilience en cas de perte de connectivité.
D’ici 2026, les architectures de calcul périphérique intégreront de plus en plus des réseaux maillés, où des sites distribués maintiennent des connexions directes pair-à-pair en complément des liaisons vers le nuage. Les topologies maillées répartissent l’intelligence de traitement sur l’ensemble du réseau et permettent aux sites de conserver une autonomie partielle pendant les pannes du réseau étendu. Évaluez la répartition géographique de vos sites distribués, la fiabilité de leurs connexions ainsi que leurs besoins en collaboration inter-sites lors du choix de la topologie. Les emplacements critiques ou éloignés tirent particulièrement profit des déploiements de calcul périphérique compatibles avec les réseaux maillés.
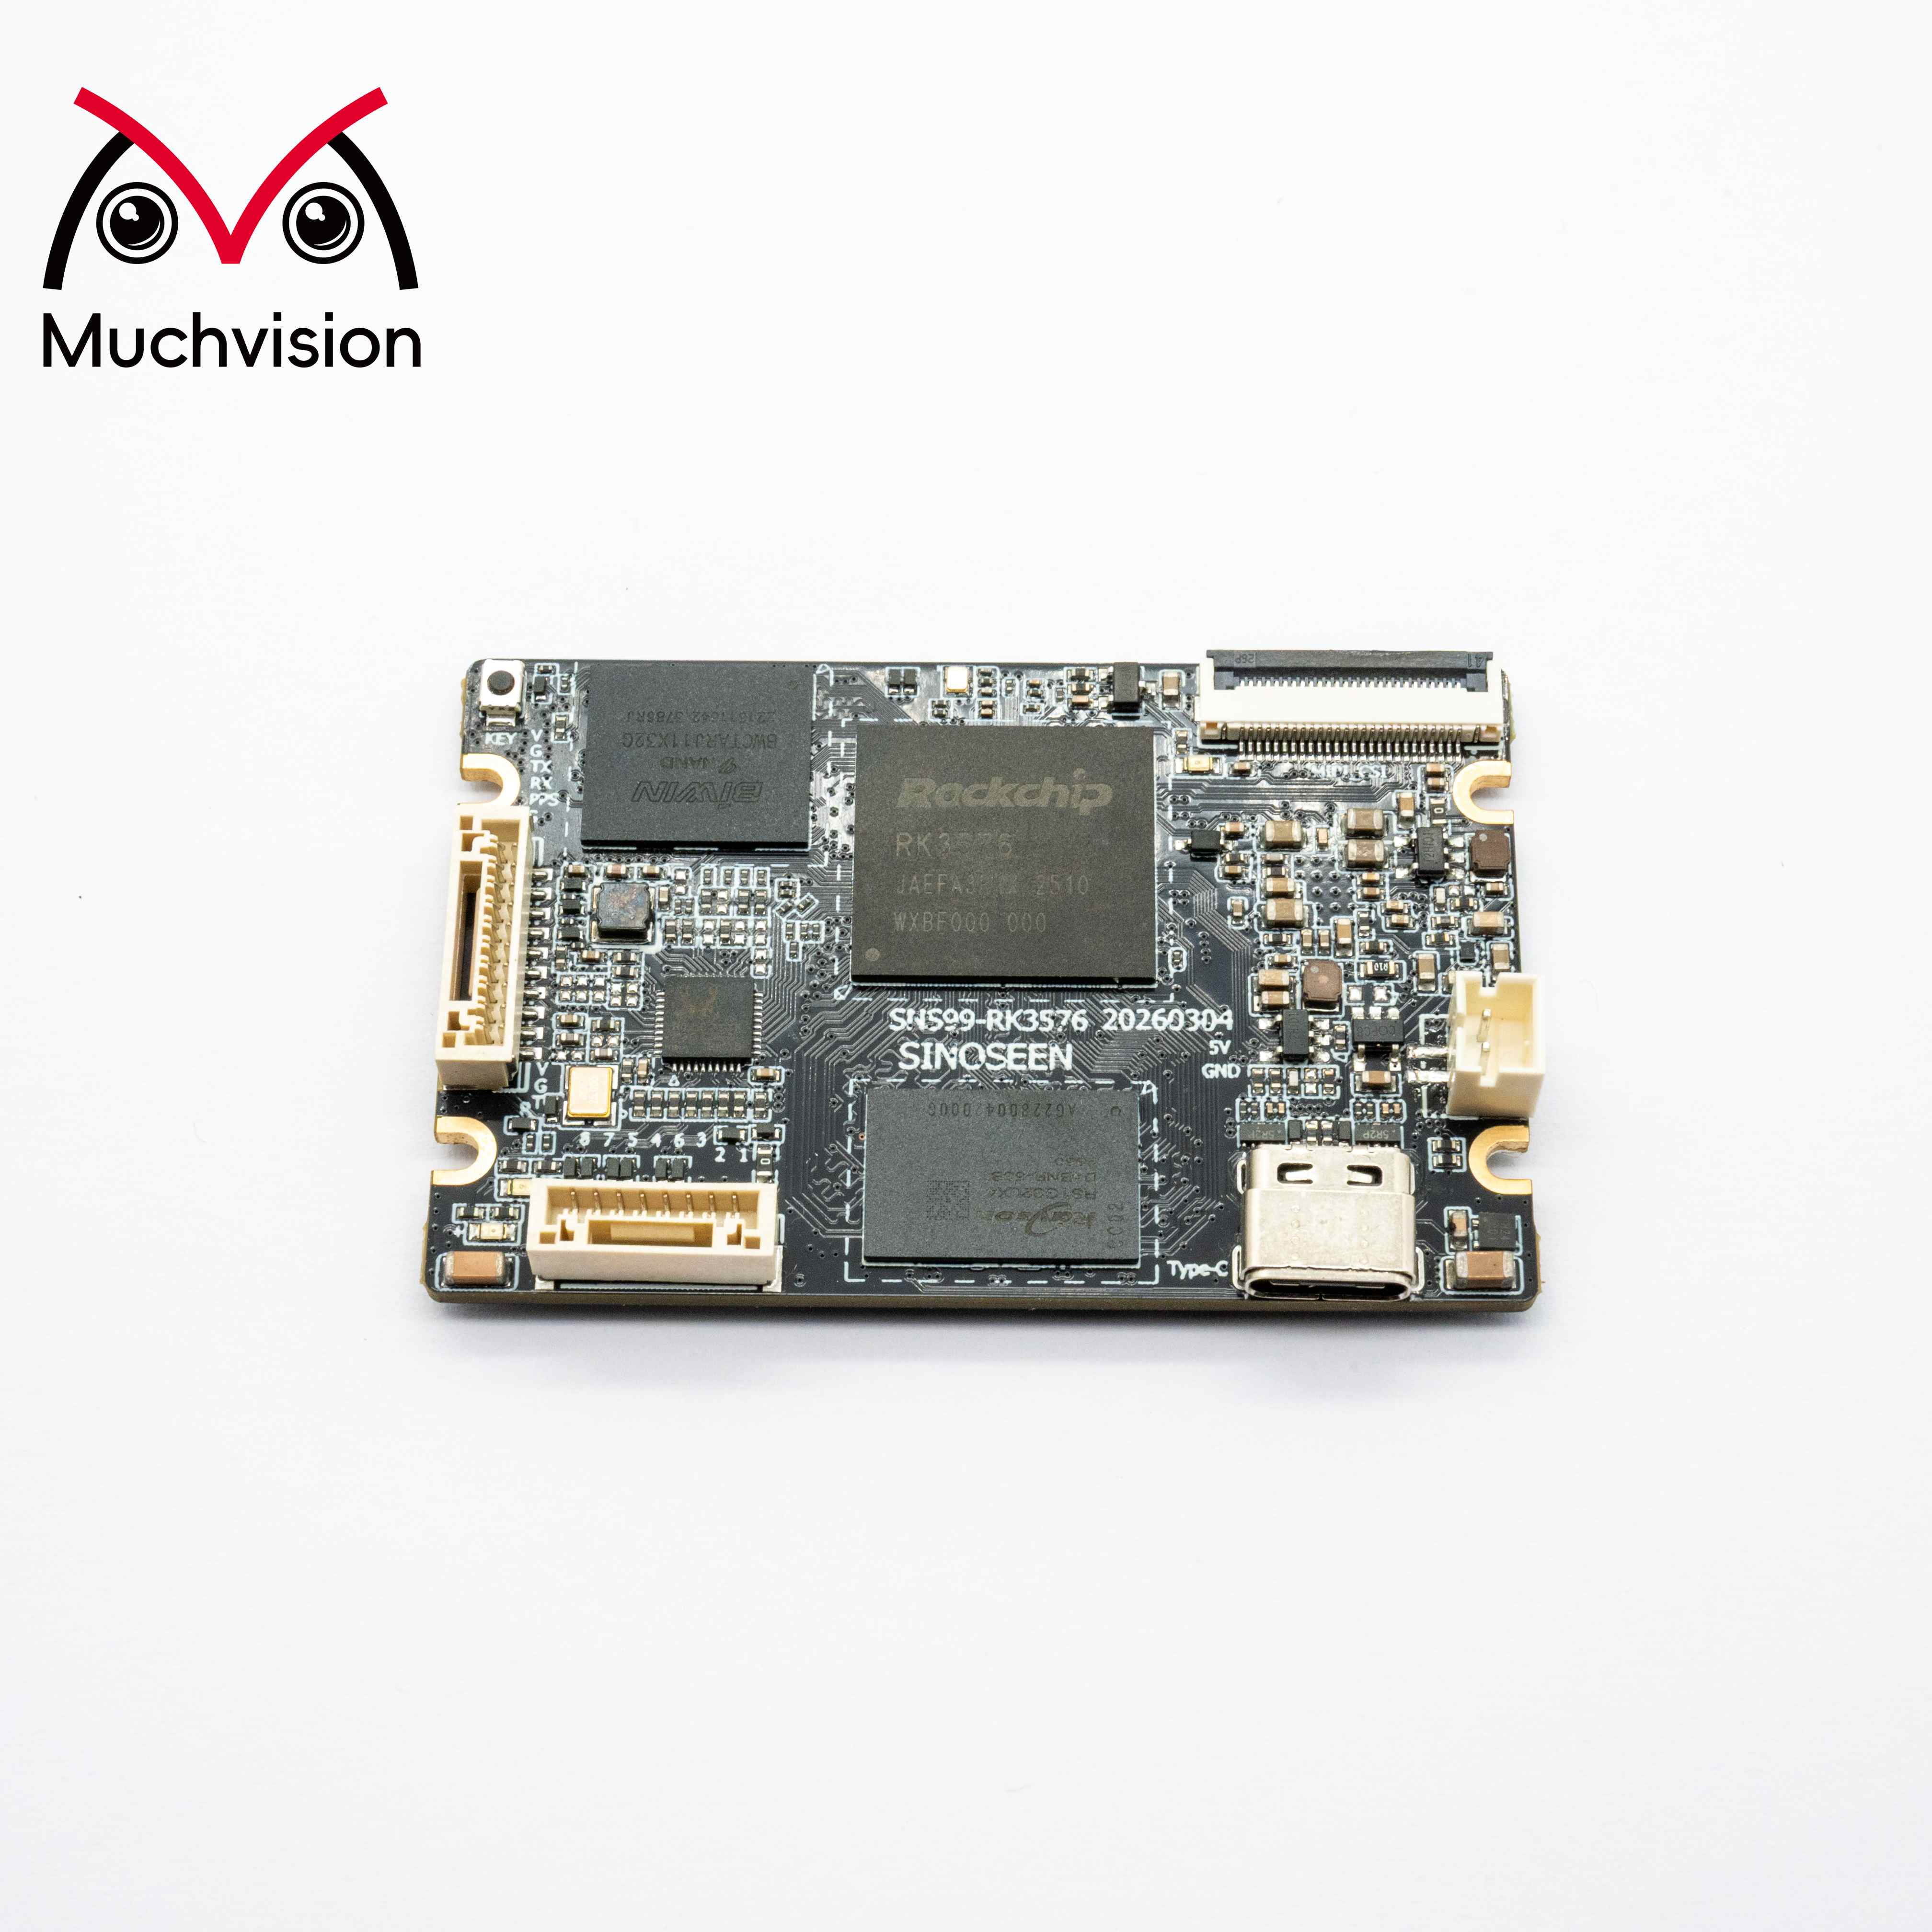
Le matériel informatique de périphérie va des passerelles IoT robustes consommant quelques watts aux ordinateurs industriels sans ventilateur exécutant des clusters Kubernetes complets. Pour les sites distribués présentant des charges de travail modérées, les solutions informatiques de périphérie basées sur des processeurs ARM ou des cartes x86 compactes offrent une efficacité énergétique et une simplicité thermique essentielles dans des environnements exigeants. Pour les charges de travail intensives en calcul ou en inférence IA, des serveurs informatiques de périphérie renforcés équipés de GPU dédiés ou d’accélérateurs neuronaux fournissent les performances requises. La conteneurisation à l’aide de Docker et de Kubernetes permet un déploiement logiciel cohérent sur des infrastructures hétérogènes d’informatique de périphérie réparties sur différents sites, simplifiant ainsi les mises à jour et la gestion des versions.
La sélection des logiciels pour l’informatique en périphérie doit équilibrer la richesse des fonctionnalités et les contraintes liées aux ressources. Des distributions Linux légères et des environnements d’exécution de conteneurs minimaux préservent la capacité de traitement destinée aux applications. Privilégiez des plateformes d’informatique en périphérie compatibles à la fois avec les outils natifs du cloud et avec les protocoles industriels traditionnels, afin de relier les déploiements IoT hérités aux charges de travail modernes. Votre stratégie d’informatique en périphérie pour 2026 devra intégrer des cadres d’intelligence artificielle émergents, des bases de données temps réel et des normes de sécurité, sans nécessiter de refonte architecturale.
Les sites de calcul périphérique distribués multiplient votre surface d’attaque, ce qui exige une authentification robuste, un chiffrement fiable et une détection des anomalies à chaque nœud. Mettez en œuvre une authentification basée sur des certificats pour les dispositifs de calcul périphérique communiquant avec les systèmes centraux, et appliquez la signature cryptographique des mises à jour logicielles distribuées aux emplacements distants. Le stockage et le traitement de données sensibles sur les nœuds de calcul périphérique—en particulier dans les contextes IoT industriels—nécessitent des contrôles d’accès rigoureux ainsi qu’une journalisation des accès.
La surveillance opérationnelle des déploiements de calcul en périphérie (edge computing) sur de nombreux sites exige l’automatisation et l’intelligence. Des tableaux de bord centralisés affichant l’état de santé, les indicateurs de performance et la latence provenant de chaque site distribué permettent une détection rapide des problèmes. Envisagez des plateformes de calcul en périphérie offrant un approvisionnement sans intervention (zero-touch provisioning), une découverte automatique des appareils et des mises à jour logicielles par diffusion (push-based), afin de réduire au minimum la charge de travail informatique sur site. D’ici 2026, les outils de gestion du calcul en périphérie devraient intégrer une détection d’anomalies pilotée par l’IA ainsi que des fonctionnalités d’autoréparation, rendant les déploiements distribués à grande échelle plus durables.
Le calcul en périphérie permet généralement des latences de 1 à 50 millisecondes pour le traitement local, contre 50 à plus de 500 millisecondes pour les allers-retours vers le cloud. La latence réelle dépend de la distance entre vos capteurs IoT et le point de calcul en périphérie, de la complexité du traitement et de la qualité du réseau. Des architectures de calcul en périphérie bien conçues pour des sites distribués réduisent au minimum la variabilité et garantissent des temps de réponse déterministes pour les charges de travail critiques, rendant ainsi la latence prévisible plutôt que simplement faible.
Le nombre de nœuds dépend de la répartition géographique, de la densité des dispositifs IoT, des exigences en matière de redondance et de la latence souhaitée. Une règle pratique consiste à placer le calcul en périphérie à proximité des sources de données IoT afin de réduire au minimum le nombre de sauts entre capteur et point de calcul en périphérie, puis à regrouper les nœuds de calcul en périphérie par région là où la connectivité et l’efficacité administrative le permettent. Commencez avec un nœud de calcul en périphérie par site majeur ou par 50 à 100 dispositifs IoT, puis étendez le déploiement en fonction des performances mesurées et des objectifs de disponibilité.
Les normes de calcul en périphérie, l’accélération de l’IA et les pratiques de sécurité évoluent rapidement. Intégrez de la flexibilité dans votre architecture distribuée de sites en adoptant des charges de travail conteneurisées, un matériel modulaire et des couches de gestion « API-first ». D’ici 2026, de nombreuses organisations intégreront des modèles de langage volumineux (LLM) et un raisonnement IA en temps réel dans leurs nœuds de calcul en périphérie ; veillez donc à ce que votre architecture prenne en charge les mises à jour logicielles et l’accélération GPU sans nécessiter de refonte physique.
 Actualités chaudes
2026-09-21
2026-09-18
2026-09-14
2026-09-13
2026-09-09
2026-09-09

 EN